AI搜索开始读图看视频:多模态内容的6项GEO优化
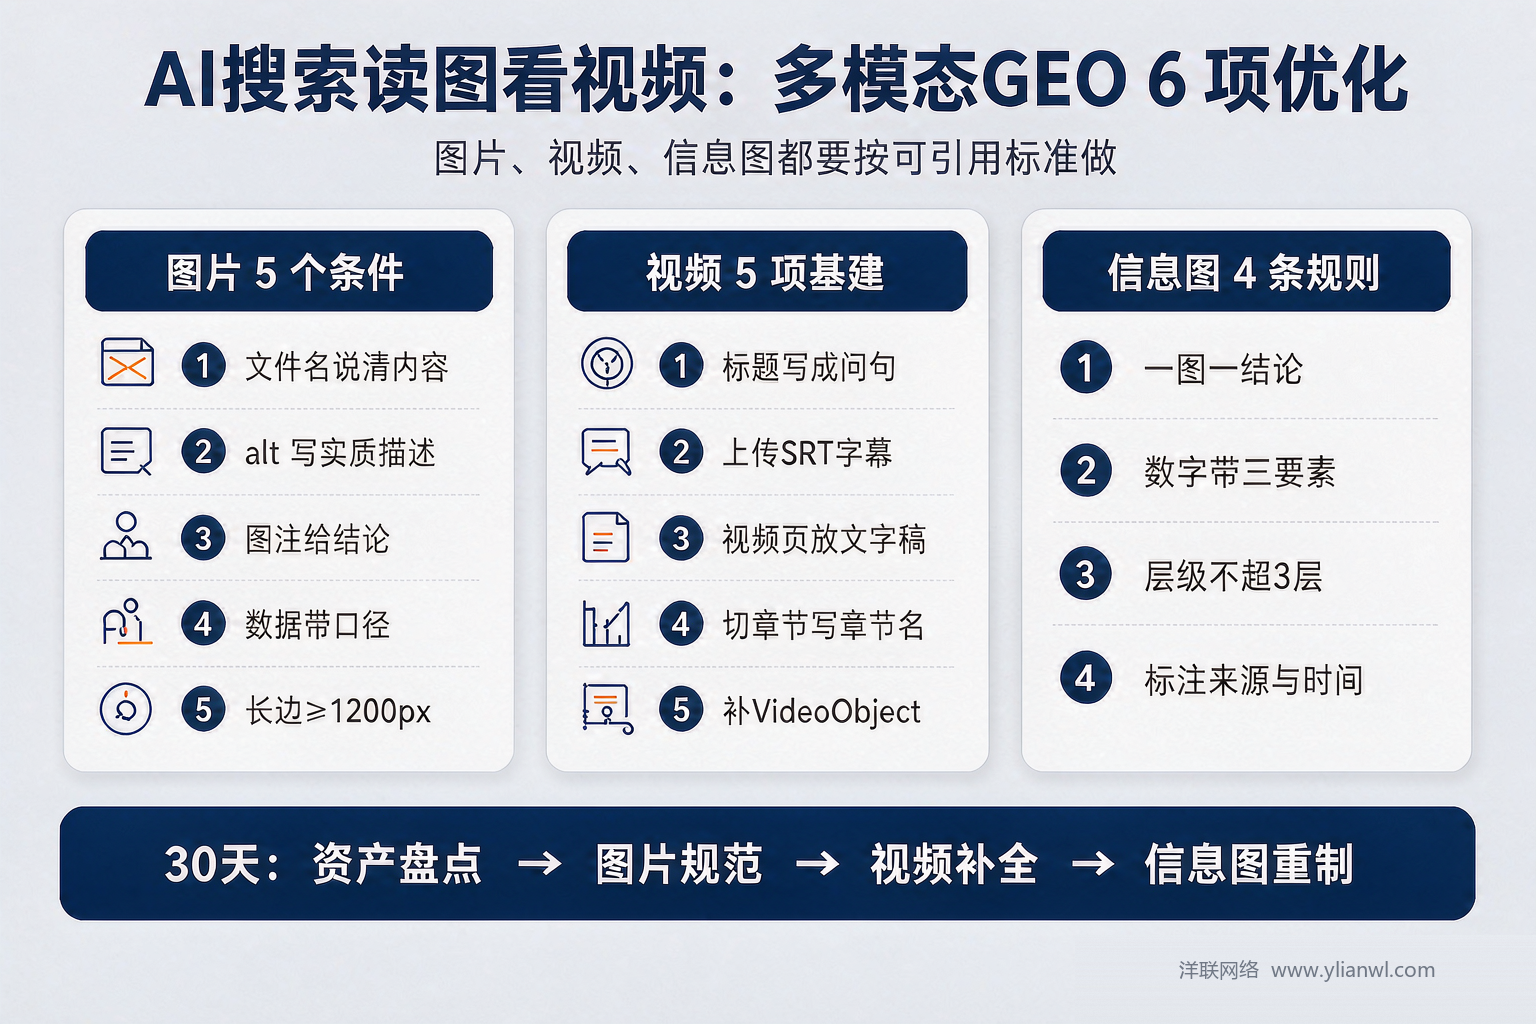
很多企业做GEO推广只优化文字,结果AI在回答「哪家工厂的硅胶厨具做工好」时,引用了同行的产品图、车间视频和信息图,却没有引用你。原因是多模态内容已经成为AI答案的一部分,而图片和视频的可读性、可抽取性、可验证性,跟正文一样需要设计。本文把多模态GEO拆成6项可执行优化:图片5个条件、视频5项基建、信息图4条规则、2类结构化数据、30天节奏、5项验收指标。
一、AI答案里已经出现图、表和视频
在豆包、腾讯元宝、文心一言这类产品里问一个采购问题,返回的答案常常带三样东西:一张产品图或场景图、一段来自视频页的文字、一张对比表格。这不是装饰,而是模型在「检索—抽取—组织」过程中,把不同模态的信息拼进了同一个回答。
| 模态 | AI 实际读的是什么 | 企业常见的浪费 |
|---|---|---|
| 图片 | 文件名、alt 文本、图注、图片周边正文、页面结构化数据 | 图片叫 IMG_2381.jpg,alt 为空,图注写「产品展示」 |
| 视频 | 标题、简介、字幕/文字稿、章节标题、视频页正文 | 视频只有标题,没有字幕也没有文字稿,模型读不到内容 |
| 图表/信息图 | 图中的文字、数字、单位、图例,以及图注里的结论句 | 信息图里全是字,但没有一句可被引用为答案的结论 |
| 表格 | 表头、行列关系、单元格文本 | 用图片截图代替真表格,行列关系丢失 |
一个判断标准:把你官网上的图全部隐藏,只留文字,AI 还能不能回答「你的产品长什么样、用在什么场景、和竞品差在哪」。如果答案是「不能」,说明多模态资产目前对AI是零信息量。
二、图片被引用的5个条件
图片要想进入AI的候选池,需要同时满足5个条件。这5项没有一项需要重新拍图,全部是发布环节的规范问题。
| 条件 | 具体做法 | 常见反例 | 自检方法 |
|---|---|---|---|
| 文件名说清内容 | 用「产品-材质-场景-角度」,如 silicone-spatula-heat-resistant-kitchen.jpg | DSC_0921.jpg、微信图片_2026.jpg | 随机抽20张图,看文件名能否猜出内容 |
| alt 写实质描述 | 一句话说清「什么产品、什么特征、什么场景」,40—80字 | alt 为空,或全站写「洋联网络」 | 关掉图片看页面,文字是否仍能读懂 |
| 图注给结论 | 图下一行写这张图证明了什么,带数字 | 图注写「图1」或「产品图片」 | 图注单独拿出来,是否是一句可引用的陈述 |
| 图上数据带口径 | 信息图里的数字带单位、时间、样本量 | 「提升300%」不写对比基准 | 任取一个数字,能否说清跟谁比、比什么 |
| 尺寸与可读性达标 | 长边 ≥1200px,图中文字占图高 ≥3% | 手机截图放大后文字糊成一团 | 缩到手机宽度,图上最小字是否还认得出 |
这五项里,投入产出最高的是第二项和第三项。alt 和图注是模型最容易直接读取的两段文字,它们决定了这张图在检索阶段会不会被召回。
三、视频的5项基建
视频被引用,靠的不是播放量,而是「视频里的信息能不能变成文字被读到」。5项基建按优先级排序:
- 标题写成问句或结论句。「硅胶铲能耐多少度?230℃实测与3种材质对比」比「公司宣传片」有用得多。
- 上传字幕文件。平台自动识别错字多,自己上传带标点的 srt,模型抽取的准确率明显更高。
- 在视频页放完整文字稿。把口播内容整理成 800—1500 字的分段文字,配小标题。视频页的正文,往往比视频本身更容易被引用。
- 切章节并写章节名。3—8 个章节,每个章节名是一个具体问题,例如「如何判断硅胶是否食品级」。
- 补 VideoObject 结构化数据。至少包含 name、description、thumbnailUrl、uploadDate、duration、contentUrl。
第3项最容易被跳过,也最有效。一个只有播放器、没有文字的视频页,对AI来说等于一个空页面。
四、信息图的4条设计规则
信息图是企业最常做、也最容易做废的多模态资产。做废的典型样子是:一张图塞了20个要点,每个要点8个字,没有结论,也没有数据来源。可按4条规则改:
| 规则 | 做法 | 目的 |
|---|---|---|
| 一图一结论 | 每张图只回答一个问题,标题即结论 | 让图有一个可被整段引用的核心句 |
| 数字带三要素 | 数值 + 单位 + 口径(对比基准/时间/样本) | 避免被判定为无来源的营销数字 |
| 层级不超过3层 | 主题—分组—条目,最多三层 | 保证模型能还原结构关系 |
| 标注来源与时间 | 图脚写数据来源与更新月份 | 提升可信度,符合E-E-A-T要求 |
一张合格的信息图,应该能做到:把图注单独摘出来发给同事,对方不看图也能明白结论。
五、两类结构化数据怎么写
结构化数据是多模态内容的「说明书」,告诉模型这张图、这个视频分别是什么。最常用的两类字段如下:
| 类型 | 必填字段 | 建议补充字段 |
|---|---|---|
| ImageObject | contentUrl、name、description、width、height | caption、license、creator、datePublished |
| VideoObject | name、description、thumbnailUrl、uploadDate、duration | transcript、hasPart(章节)、contentUrl、publisher |
写法上有两个硬要求:一是 contentUrl 必须是可公开访问的绝对地址,不能是需要登录的链路;二是 description 要写具体内容,不要复制标题。同一页面有多张图时,用 @graph 数组逐一声明,不要只标第一张。
六、30天落地节奏
| 周次 | 动作 | 产出 | 验收标准 |
|---|---|---|---|
| 第1周 | 资产盘点 | 图片/视频/信息图清单,标注可引用与不可引用 | 明确三类资产各有多少张(条)需要返工 |
| 第2周 | 图片规范 | 文件名、alt、图注三项全站替换 | 抽检20张,三项合格率≥90% |
| 第3周 | 视频补全 | 字幕、文字稿、章节、VideoObject | 每个视频页正文≥800字、章节≥3个 |
| 第4周 | 信息图重制 | 每张图一结论、数字带口径、标注来源 | 图注可独立成句,数据可追溯 |
第1周不要急着改,先把「哪些图值得改」分出来。产品主图、工艺流程图、对比图、认证图这四类优先,其余配图可以放着。
七、5项验收指标
| 指标 | 口径 | 常见基线 | 90天目标 |
|---|---|---|---|
| 图片信息完整率 | alt+图注+文件名三项齐全的图片占比 | 20%—40% | ≥90% |
| 视频文字稿覆盖 | 有完整文字稿的视频页占比 | 10%左右 | 100% |
| 多模态引用次数 | AI答案中出现自家图片/视频的次数 | 0—2 次/月 | ≥8 次/月 |
| 图片搜索点击 | 图片搜索带来的会话数 | 占比 <2% | 占比 5%—8% |
| 信息图被引用率 | 被外部页面或AI引用的信息图数量 | 0—1 张 | ≥5 张 |
第3项要用工具持续记录,别凭感觉。记录方式很简单:固定20条问句,每周在4个平台各问一次,截图存档,统计自家图片或视频出现的次数。
八、常见问题
问:图片必须用英文文件名吗? 答:不必。用拼音或中文都可以,关键是「能看懂内容」。如果面向海外客户,英文文件名更利于跨语言检索,但alt和图注的准确性比文件名重要得多。
问:产品图加了水印会影响AI识别吗? 答:会有影响。大面积半透明水印会降低图中文字的识别率,尤其是压在参数、型号位置上的水印。建议水印放在边角、不透明度不超过30%,且不要遮住主体。
问:视频一定要上传到YouTube或抖音吗? 答:建议双轨。官网放完整文字稿和结构化数据,是给AI的稳定信源;平台放视频,是给流量和外部信号。只发平台不发官网,等于把内容资产放在别人的服务器上。
问:信息图里文字多是不是更好? 答:不是。信息图的价值在于「结构 + 结论」,不是把文章塞进图里。一张图超过120个字,阅读和识别都会下降,建议把细节留在正文,图里只放关键数字和结论。
问:这套优化对豆包、DeepSeek、元宝、文心一言都有效吗? 答:有效,侧重不同。豆包、元宝在回答里更常直接展示图片和视频封面,对缩略图质量、图注准确性敏感;DeepSeek、文心一言在检索增强模式下更依赖文字稿和结构化数据,因为最终引用的是文字。两者都要做。
问:没有视频团队怎么办? 答:从「一图一文」开始。用手机拍30—60秒的工艺片段,配上字幕和200字文字稿,比不做要好。多模态GEO的门槛不在制作精度,而在信息是否被写成了文字。
九、洋联网络的多模态GEO服务
东莞市洋联网络科技有限公司2016年成立,深圳龙岗总部(天安数码城)+东莞万江双址运营,专注GEO推广、阿里巴巴1688代运营、外贸社媒推广三大业务,累计服务800+品牌客户、覆盖100+细分领域。自研FastGeo系统用于监测品牌在主流AI搜索平台的提及与引用情况,多模态资产盘点与规范化是GEO项目的第二步:先让AI走得到页面,再让AI读得懂页面里的图。
如果你的产品图、车间视频、信息图数量不少但从未被AI引用,可以带着官网地址找我们做一次多模态资产诊断。电话:13662793147。