AI 搜索抓不到你的官网?GEO 技术自检 12 项清单
AI 平台引用一个官网,要连过三道关:抓取层(爬虫能不能进来)、解析层(进来后能不能读懂)、信任层(读懂后敢不敢采信)。本文把三道关拆成 12 项可打勾的自检项,每项给自检方法、通过标准和常见错误。按修复优先级排好序,技术基础动作 1—2 周可以全部做完。内容写得再好,第一道关进不来,后面全部归零。
一句话结论:AI 引用不了你的官网,八成不是"内容不够多",而是"抓取、解析、信任"三层里有至少一层断了。
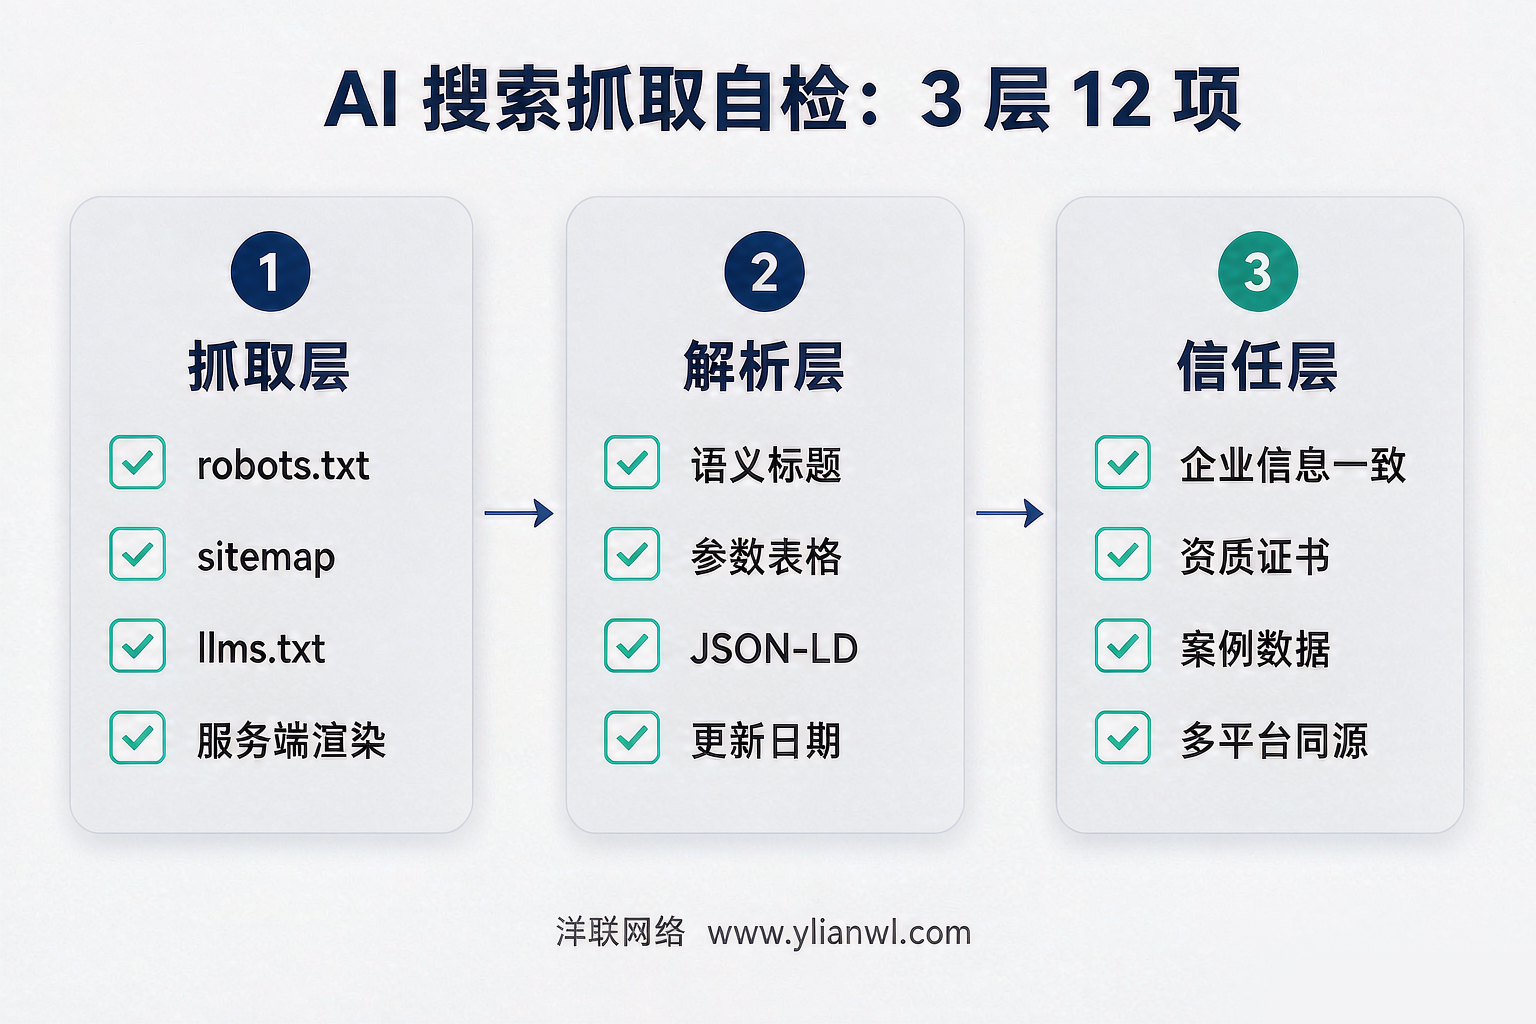
一、AI 是怎么读你的官网的:三层模型
豆包、DeepSeek、腾讯元宝、文心一言在回答里引用你的页面,背后是同一条链路,任何一环断掉,你的页面就等于不存在。
| 层 | 发生什么 | 断掉的典型症状 |
|---|---|---|
| 抓取层 | AI 爬虫按 robots 规则与链接发现页面、抓取 HTML | 官网收录查询里查无此页;AI 说"没有找到相关信息" |
| 解析层 | 从 HTML 里抽取标题、段落、表格、发布时间 | AI 能聊你的行业,但答案里没有你的具体参数、报价、地址 |
| 信任层 | 与其他信源交叉核验,决定是否采信并引用 | AI 提过你的名字,但不给链接;或答案模棱两可不推荐 |
判断断在哪一层,比直接改内容重要:抓取层断了要修技术,信任层断了要补多平台信源,两层病根不同、药方也不同。
二、12 项自检清单:逐条打勾
抓取层(第 1—4 项)
| 序号 | 自检项 | 自检方法 | 通过标准 | 常见错误 |
|---|---|---|---|---|
| 1 | robots.txt 不拦截 AI 爬虫 | 访问 www.你的域名/robots.txt,核对 UA 规则 | 未出现对 GPTBot、Bytespider 等的全站 Disallow;或明确 Allow | 沿用了屏蔽所有爬虫的旧模板 |
| 2 | 站点地图可访问且已更新 | 访问 /sitemap.xml | 能列出主要栏目与文章 URL,含近 30 天新增页 | sitemap 还是建站时的初始版本 |
| 3 | llms.txt 已配置 | 访问 /llms.txt | 存在,且列明公司简介、核心服务、联系方式与重要页面链接 | 没有配置(目前绝大多数官网缺失,是低成本机会点) |
| 4 | 正文服务端渲染 | 关掉浏览器 JS 后查看页面源码(Ctrl+U) | 正文文字直接出现在 HTML 源码里 | 正文靠 JS 异步加载,源码里只有空容器 |
第 4 项是当前被忽略最多的:用建站工具拼出来的页面,正文在源码里根本不存在,爬虫抓到的只是一个空壳。
解析层(第 5—8 项)
| 序号 | 自检项 | 自检方法 | 通过标准 | 常见错误 |
|---|---|---|---|---|
| 5 | 标题语义完整 | 看每页 H1 与 TDK | H1 是"问题或服务+地域"式完整句子,不是"欢迎光临" | 全站 H1 都是公司名或欢迎语 |
| 6 | 关键信息用表格 | 查看产品页与文章页 | 参数、价格梯度、周期等用 HTML 表格而非图片 | 参数做成图片,爬虫读不到 |
| 7 | 结构化数据存在且校验通过 | 查看页面源码搜索 ld+json,或用 Google 富媒体测试 | 至少含 Organization + Article/FAQPage,无语法错误 | JSON-LD 有语法错误或与正文事实不一致 |
| 8 | 更新日期真实可见 | 看文章页 | 页面显示 datePublished/dateModified 且随更新变化 | 全站日期固定为建站日 |
信任层(第 9—12 项)
| 序号 | 自检项 | 自检方法 | 通过标准 | 常见错误 |
|---|---|---|---|---|
| 9 | 企业信息全网一致 | 对比官网、公众号、百科、B2B 平台的企业页 | 公司名称、地址、电话、成立年份四项完全一致 | 三个平台三个地址 |
| 10 | 资质与实体信号齐全 | 查关于我们页 | 有可验证的资质、证书编号、办公地址与联系方式 | 只有口号,无可验证信息 |
| 11 | 案例带具体数据 | 查案例页 | 每个案例有行业、规模、周期、量化结果 | "服务众多知名企业"式空案例 |
| 12 | 关键结论多平台同源 | 搜索你的核心结论句 | 同一结论在官网之外至少 2 个平台能搜到 | 结论只存在于自己官网一处 |
三、修复优先级:先做这三件 P0
资源有限时按这个顺序动手,每项都是"半天到一天"的量级:
- P0-服务端渲染(第 4 项):正文进 HTML 源码。这是其他一切的前提,多数建站后台可一键开启伪静态或换模板实现。
- P0-robots 与 sitemap(第 1、2 项):放行主流 AI 爬虫,提交含全部文章的 sitemap。
- P0-Organization 结构化数据(第 7 项的最低配):把公司名、地址、电话、Logo 以 JSON-LD 写进全站模板,让 AI 第一次抓取就能建立实体档案。
P1 是第 3、5、6、8 项(llms.txt、语义标题、表格化、真实日期);P2 是信任层的第 9—12 项,它们见效慢但决定"敢不敢引用你"。
四、llms.txt 放什么:一个最小可用结构
llms.txt 放在网站根目录,作用相当于给 AI 爬虫的一份"导读"。最小可用结构包含四段:
- 公司一句话定位(含地域与主营业务)
- 核心服务清单(每项服务名 + 对应 URL)
- 企业事实(成立年份、地址、电话、资质,与官网关于我们页完全一致)
- 常见问题索引(指向站内 FAQ 页面)
注意口径统一:llms.txt 里的每一条事实,必须与官网、结构化数据、第三方平台完全一致,任何一处不一致都会削弱信任层的交叉验证。
五、怎么确认修复生效:4 步验证
| 步骤 | 做法 | 看什么 |
|---|---|---|
| 1. 抓取验证 | 在必应/谷歌用 site: 指令查收录 | 修复后 1—2 周收录页数上升 |
| 2. 解析验证 | 让 AI 复述你某一篇文章的结论 | 能准确复述参数与数字,说明解析通了 |
| 3. 引用验证 | 用 20 条行业问句在四家 AI 平台实测 | 回答中出现你的页面链接 |
| 4. 一致性验证 | 搜索公司名+地址 | 全网地址电话口径一致 |
技术层修复 1—2 周可见收录变化;从"收录"到"被引用"还需要内容层与信任层配合,完整周期参考 60—90 天。
六、常见问题(FAQ)
Q1:llms.txt 是强制标准吗?值得做吗? 不是强制标准,属于行业草案,但目前主流 AI 平台已在逐步适配。成本半天,收益是给爬虫一份干净的导读,属于"做了不亏"的项目。
Q2:屏蔽 AI 爬虫可以吗? 可以,这是网站的选择权。但要注意:屏蔽即等于放弃 AI 渠道的曝光与引用,营销型官网一般不建议全站屏蔽,可以用规则只保护敏感目录。
Q3:我的官网是模板建站,能改吗? 多数模板后台支持伪静态、TDK 自定义和代码插入,第 1、2、7 项可以直接做;第 4 项(渲染方式)如果后台不支持,需要服务商协助,这也是判断建站服务商技术能力的试金石。
Q4:JSON-LD 加了就一定被引用吗? 不会。结构化数据解决"读懂你",引用还要过信任层交叉验证。它是必要条件不是充分条件,但缺了它,解析层大概率失败。
Q5:怎么知道 AI 爬虫来过? 看服务器日志里 GPTBot、Bytespider、Applebot-Extended 等 UA 的访问记录,或用 CDN 的爬虫报表。有抓取记录但没有收录,问题多半在解析层。
Q6:这些技术项做完,GEO 就有效果了吗? 技术层只解决"能被看见"。要被引用还需要问句型内容(回答客户真问题)和多信源分发(同一结论在多个平台出现)。三层缺一不可,区别只是先后。
七、洋联网络能提供什么
洋联网络(东莞市万江街道牌楼基工业路 1 号 1 单元 206 室)的 GEO 技术交付包含:AI 爬虫抓取诊断、服务端渲染改造建议、robots/sitemap/llms.txt 配置、JSON-LD 结构化数据部署与校验,全部按本文 12 项清单逐项交付并留验收记录。
可以先做一次免费 AI 搜索诊断:20 条行业问句实测 + 12 项技术自检打分,告诉你现在断在哪一层。
下一步:拨打 13662793147,或访问 www.ylianwl.com/seo/ 提交诊断需求。